

Hier, le 21 septembre 2026, le compte X/Twitter Balance ton Claude a accusé le livre évènement de la rentrée, encensé par toute la presse (C’était ça ou mourir de Thélyson Orélien, paru chez Grasset), d’avoir été écrit en tout ou partie par une IA.


L’accusation s’appuie sur des éléments intéressants mais parle abusivement de certitude. Ce qui lui a été reproché par divers contradicteurs, dont certains écrivent eux-mêmes avec des IA. Le texte écrit par IA d’un certain François Negroni (qui se vante d’écrire « avec Claude, l'IA d'Anthropic »), visant à réfuter l’idée selon laquelle Thélyson Orélien aurait utilisé l’IA pour écrire son livre, a été pas mal partagé. Un pathétique spectacle de l’IA discutant avec elle-même. Bientôt plus besoin de ces humains devenus de toute façon bien trop robotiques.

Le compte « Balance ton Claude » a donc soumis à Pangram, un logiciel détecteur d’IA lui-même basé sur l’IA, plusieurs passages de C’était ça ou mourir, dont les deux premiers chapitres, et affirme avoir obtenu presque partout un classement « 100 % IA ». Il indique plus de vingt passages signalés et en conclut que le roman serait « rédigé presque intégralement » par IA. Pour donner une force statistique à l’accusation, il prend le taux de faux positifs annoncé par Pangram (0,0041 %) et l’élève à la puissance 20. Le post a ensuite été largement diffusé. Cependant, on note plusieurs problèmes.
Le premier, c’est que les vingt tests ne sont pas indépendants les uns des autres. Il s’agit de vingt passages du même livre. Si Pangram se trompe à cause d’une caractéristique particulière de l’écriture de l’auteur, il peut faire la même erreur vingt fois. On ne peut donc pas calculer la probabilité d’erreur en multipliant simplement 0,0041 % par lui-même vingt fois.
Le deuxième problème, c’est que le chiffre de 0,0041 % signifie que parmi des textes humains, Pangram en classe à tort 0,0041 % comme IA (selon l’entreprise). Pas que lorsqu’un texte est classé IA, il n’y a que 0,0041 % de chances qu’il soit en réalité humain. Il s’agit de deux probabilités différentes.
Ensuite, les chiffres cités ne concernent pas exactement la même population. Le 0,0041 % est le résultat de Pangram 4 sur un million de documents anglais FineWeb ; sur le corpus multilingue FineWeb2, Pangram annonce 14 faux positifs sur 996 273 documents, et son rapport technique donne pour le français environ 0,0026 %. Aucun de ces corpus n’est un échantillon représentatif de romans littéraires français contemporains.
Enfin, à moins d’avoir défini avant le test quels passages seraient analysés, il existe un problème possible de biais de sélection. En testant énormément de fragments mais en ne montrant que ceux qui déclenchent le détecteur, le résultat est beaucoup moins impressionnant.
Mais ça ne veut pas dire que l’observation initiale est insignifiante. Une étude indépendante publiée en 2026 a déterminé que Pangram était nettement meilleur que GPTZero, Turnitin et Copyleaks sur son corpus expérimental, notamment pour les textes entièrement générés, hybrides et « humanisés ». Ce travail portait cependant sur des textes académiques anglais, pas sur des romans français. Ainsi, si de longs passages, répartis dans tout le livre et choisis sans biais, ressortent systématiquement comme IA, des questions se posent. Mais ce n’est pas une preuve.
Dans son texte visant à écarter le moindre doute sur l’authenticité du livre en question, le cyborg Negroni affirme en substance que Pangram prendrait pour de l’IA la langue particulière d’Orélien, « créolisée », traversée par l’exil et les langues : « le détecteur ne repère pas l’IA, il repère l’accent ». Or rien dans les données présentées ne permet d’établir ça.
L’étude de Stanford mentionnée est réelle. En 2023, sept détecteurs de l’époque ont effectivement produit énormément de faux positifs sur 91 dissertations TOEFL rédigées en anglais par des locuteurs chinois non natifs. Mais le phénomène observé était notamment lié à une faible diversité lexicale et syntaxique et à une faible perplexité : les textes employant un vocabulaire plus restreint étaient trop prévisibles et ressemblaient davantage aux sorties des modèles. Ce n’était pas une étude sur la prose française, le créole, les écrivains migrants ou la littérature expérimentale, et Pangram 4 n’existait pas encore.
Plus embarrassant encore pour cet argument, il s’avère que Pangram 4 a précisément été évalué sur des corpus de personnes dont l’anglais n’est pas la langue maternelle. Il rapporte un seul faux positif sur 24 586 textes d’apprenants anglophones, et aucun sur le corpus TOEFL de Liang utilisé dans l’étude de Stanford. Il s’agit d’une évaluation de l’entreprise, ça ne garantit évidemment pas que le système soit exempt de biais. Mais citer l’étude de Liang pour affirmer que Pangram 4 « repère l’accent » est donc assez discutable.
En outre, il est absurde de postuler sans aucun élément de preuve que le style d’Orélien serait ce qui déclenche Pangram. Le cyborg/Negroni se permet même de trancher sur la base de rien du tout que « Thélyson Orélien, lui, écrit seul ». Si l’IA le dit…
Par ailleurs, sa mention de Samuel Fitoussi (qui aurait rapidement relayé l’accusation), de ses intérêts dans l’IA, de sa « position de classe », du « pré carré » des intellectuels, est à peu près hors sujet. Je déteste ces gens moi aussi, mais ça n’est pas un argument.
Il y aurait des moyens de tenter d’y voir plus clair. Notamment en essayant de trouver des textes d’Orélien datant d’avant la démocratisation des IA génératives (avant début 2023, grosso modo) et en effectuant des comparaisons. J’ai réussi à en trouver vingt, écrits entre 2010 et 2017. La différence littéraire (différence de style, de forme) est assez flagrante pour qui sait encore lire. Et Pangram les détecte presque tous comme 100 % humains. Presque. Le logiciel estime (à tort, il s’agit donc de faux positifs) que quelques-uns sont « partiellement écrits » par une IA. Sur 20 textes (dont celui-ci, celui-là ou encore cet autre, n’hésitez pas à les lire), il en détecte 14 comme 100% humains, 6 comme « mixed » (« nous pensons que ce texte est un mélange d’IA, d’assistance par IA et d’écriture humaine »), et 0 comme écrits par une IA. Ces résultats suggèrent que ce n’est sans doute pas l’écriture prétendument « migrante » d’Orélien que Pangram aurait détecté dans son nouveau roman (sauf si Orélien a très récemment appris à écrire « migrant »).
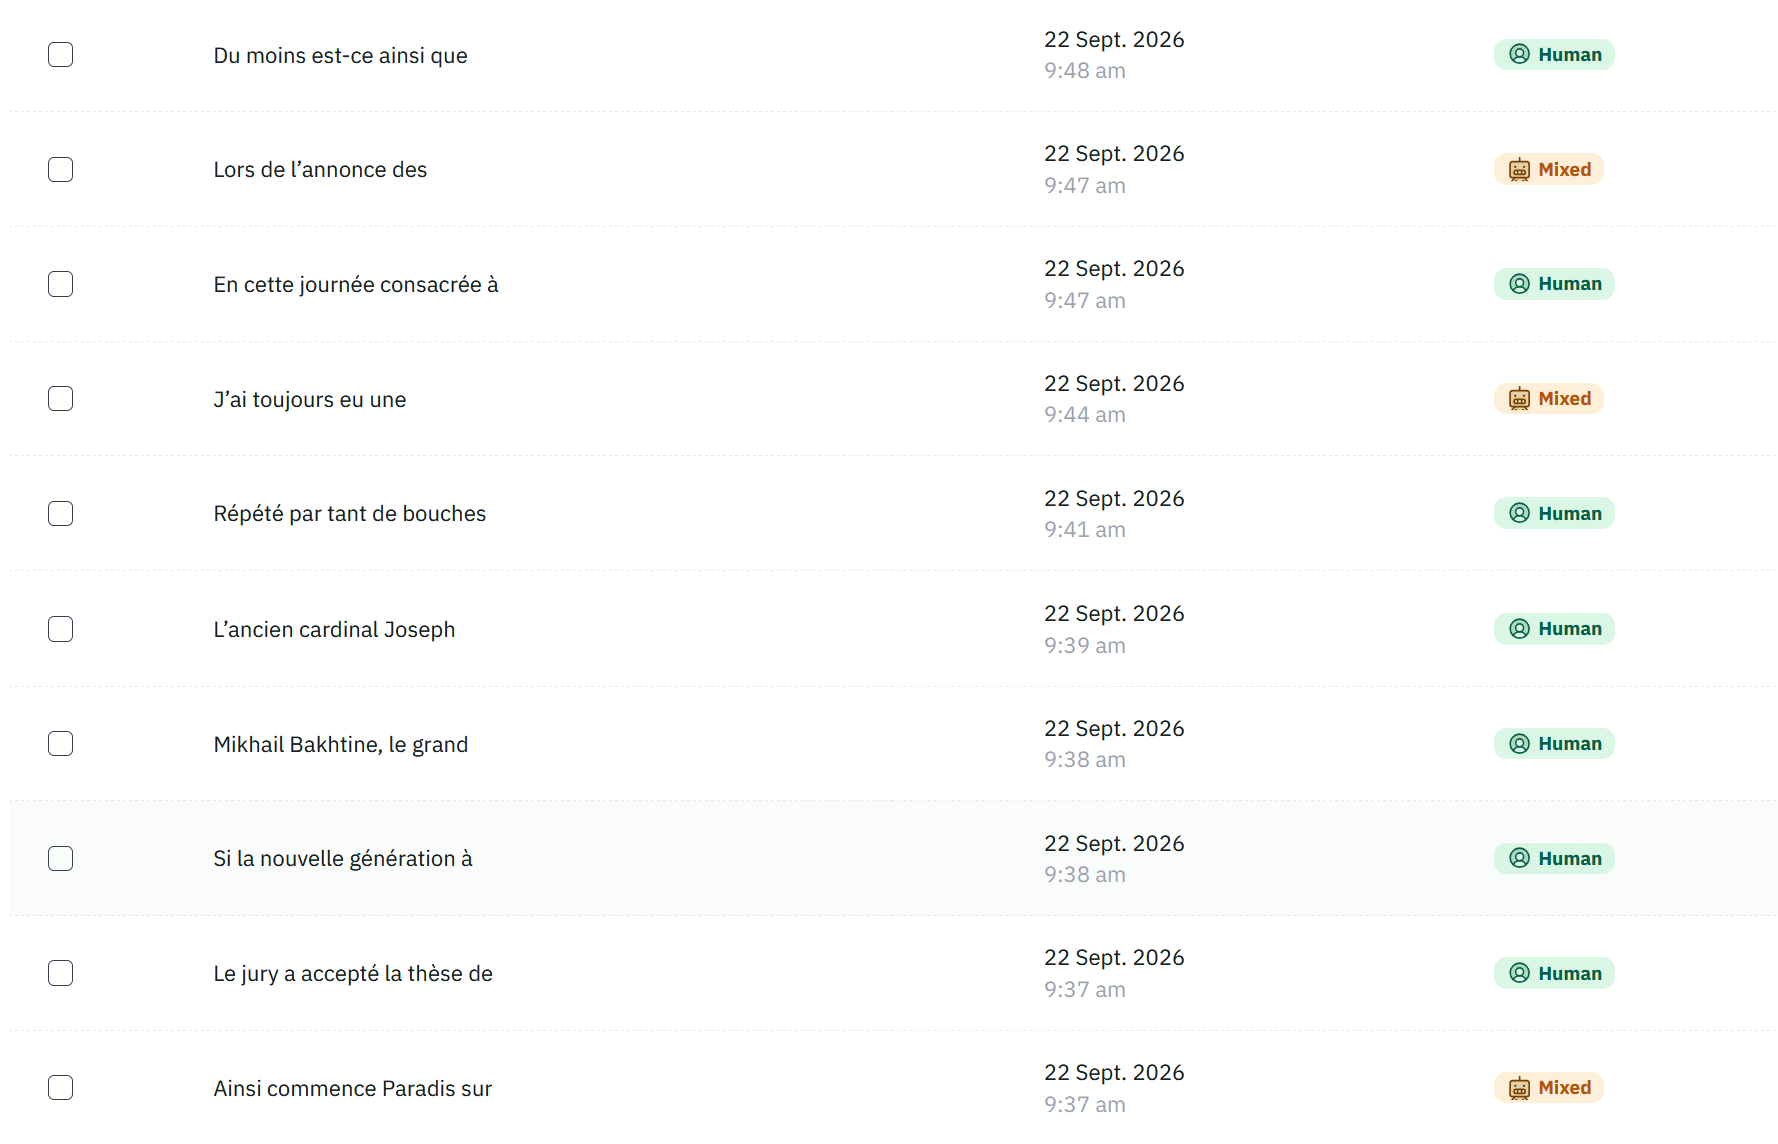
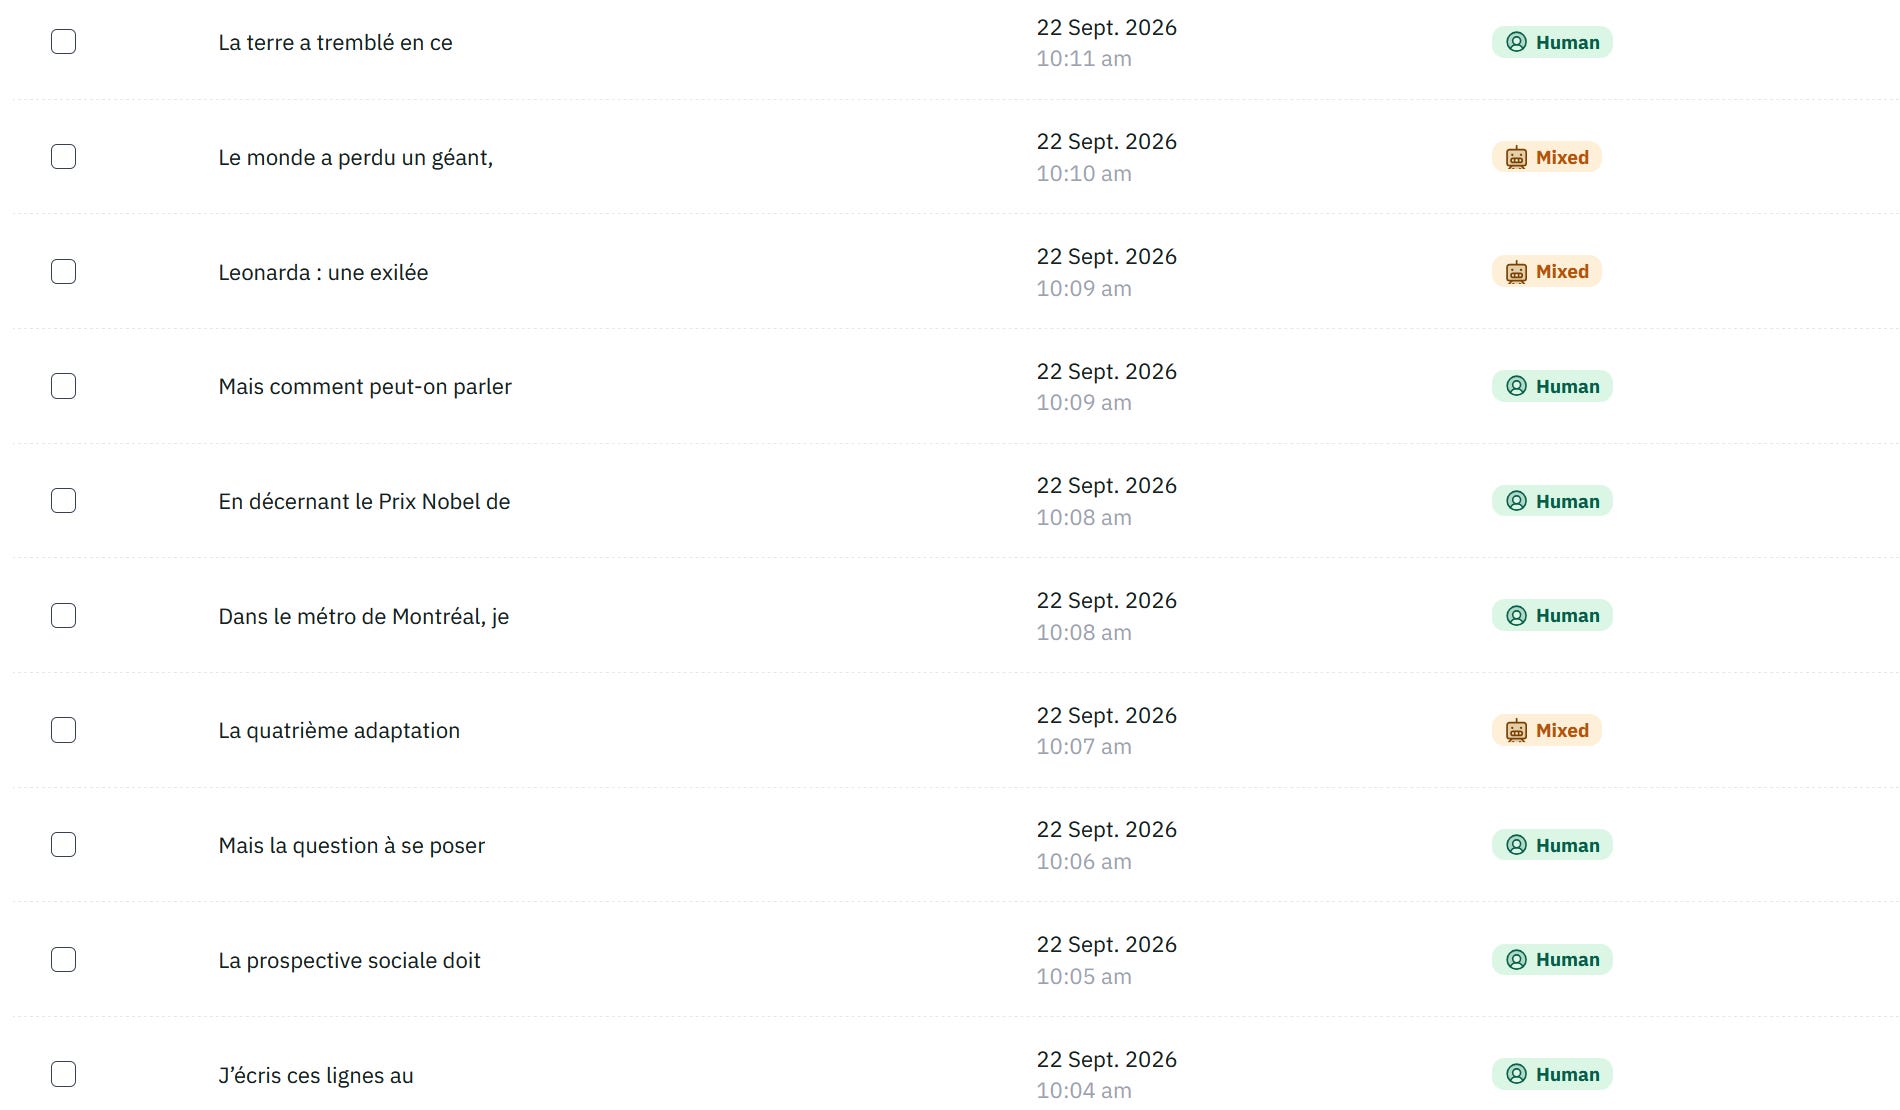
J’ai réussi à trouver des textes d’Orélien antérieurs à 2022, donc, mais ça n’a pas été facile parce que les trois sites internet où il publiait (erramag.com ; thelysonorelien.com ; portdattache.mondoblog.org) sont hors service (erreur 404). Il est cependant possible, via archive.org (The Wayback Machine), d’exhumer quelques-uns de ses anciens écrits.
Quid de ses textes plus récents ? Sur les 4 articles d’Orélien publiés sur le site du quotidien québecois La Presse (www.lapresse.ca), tous écrits en 2026, 3 sont qualifiés de 100% IA par Pangram et 1 est jugé « mixed ». Sur 13 textes d’Orélien ultérieurs à 2023 que j’ai testés, comprenant les 4 articles de lapresse.ca ainsi que d’autres choisis au hasard sur erramag.com et sur thelysonorelien.com, 8 sont classés 100% IA et 5 « mixed ». Aucun n’est considéré comme 100% humain.
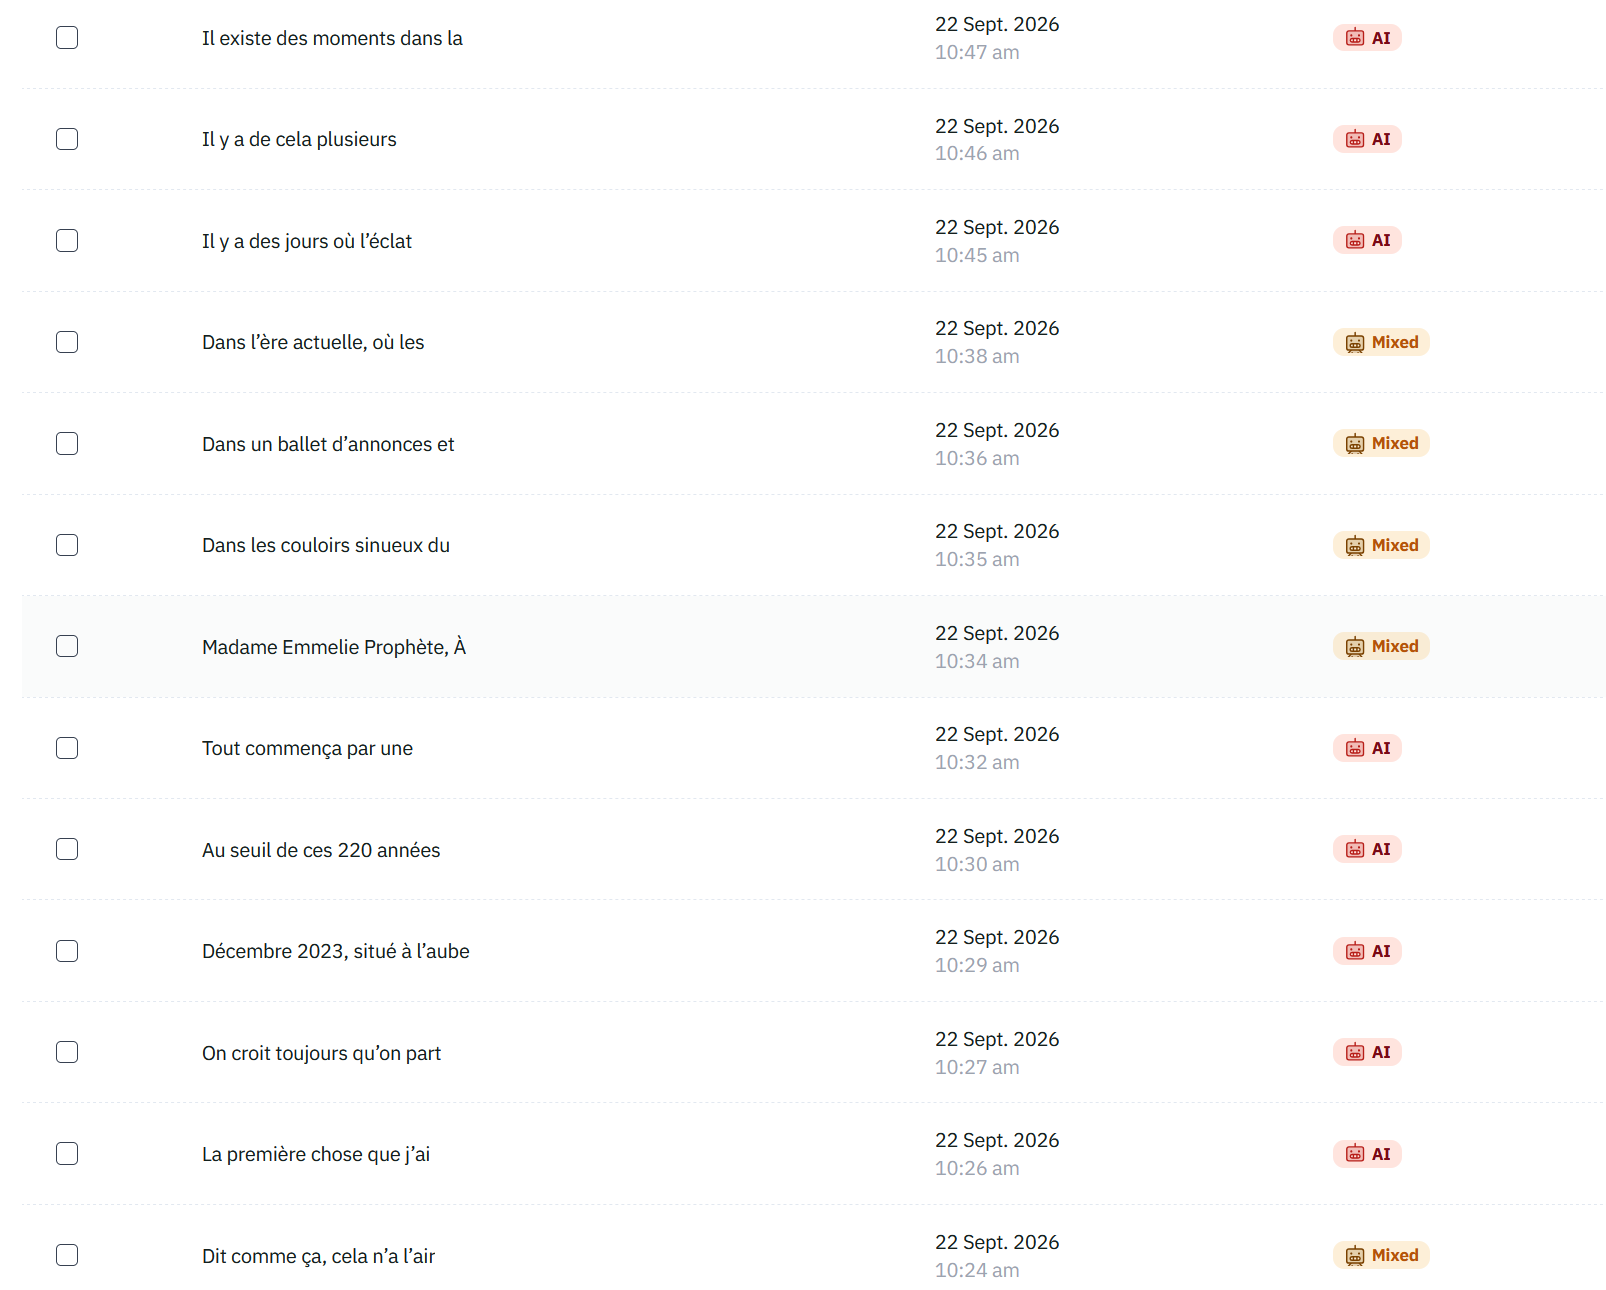
Entre l’ère pré-IA et l’ère IA, on passe donc d’une détection largement humaine à du largement IA. Et la plupart des lecteurs et lectrices repèreraient sans doute assez facilement un changement majeur de style. Personnellement, ça m’a semblé évident.
Bon, et ? Eh bien tout ce qui précède ne permet effectivement pas d’affirmer que le nouveau livre d’Orélien est écrit par une IA. Mais il me semble que cela suggère que le doute est bien permis et qu’une enquête plus poussée serait légitime.
C’est-à-dire que contrairement à ce que beaucoup prétendent à gauche, toute cette affaire, c’est pas juste du racisme, c’est pas juste parce que l’auteur est noir. Oui, on constate du racisme dans les réactions d’imbéciles de droite, mais non, il y a peut-être vraiment anguille sous roche.

Louis Witter a raison de dénoncer les assertions péremptoires. Mais la possibilité que le phénomène littéraire de la rentrée célébré par tous les médias de masse soit écrit par une IA ne semble pas l’inquiéter. Après tout, que l’humanité soit graduellement supplantée par des machines, quelle importance ? (On remarque aussi une belle hypocrisie à gauche, où l’on s’empresse donc, ironiquement, de prendre la défense d’un bouquin publié par l’empire commercial du milliardaire d’extrême droite Bolloré.)
Pour y voir plus clair, il s’agirait par exemple de comparer systématiquement un corpus de textes anciens et récents d’Orélien avec le même protocole, de répéter les tests à plusieurs reprises pour vérifier la stabilité des résultats (il s’agit ou s’agissait apparemment d’un défaut de certains détecteurs comme Pangram) et de compléter Pangram par d’autres outils pour voir s’ils repèrent eux aussi une rupture. On pourrait aussi recourir à une analyse stylométrique pour voir si l’écriture d’Orélien change réellement autour de 2023. On pourrait aussi examiner les traces de fabrication du roman (brouillons, versions successives, échanges avec l’éditeur).
Le mieux serait évidemment que l’auteur lui-même nous dise ce qu’il en est.
Personnellement, ayant eu l’occasion d’utiliser des LLM (Large Language Model), en lisant le livre d’Orélien, j’ai l’impression qu’il y a beaucoup d’IA dedans. Sur Babelio, une personne a posté quelques extraits représentatifs après un commentaire critique :
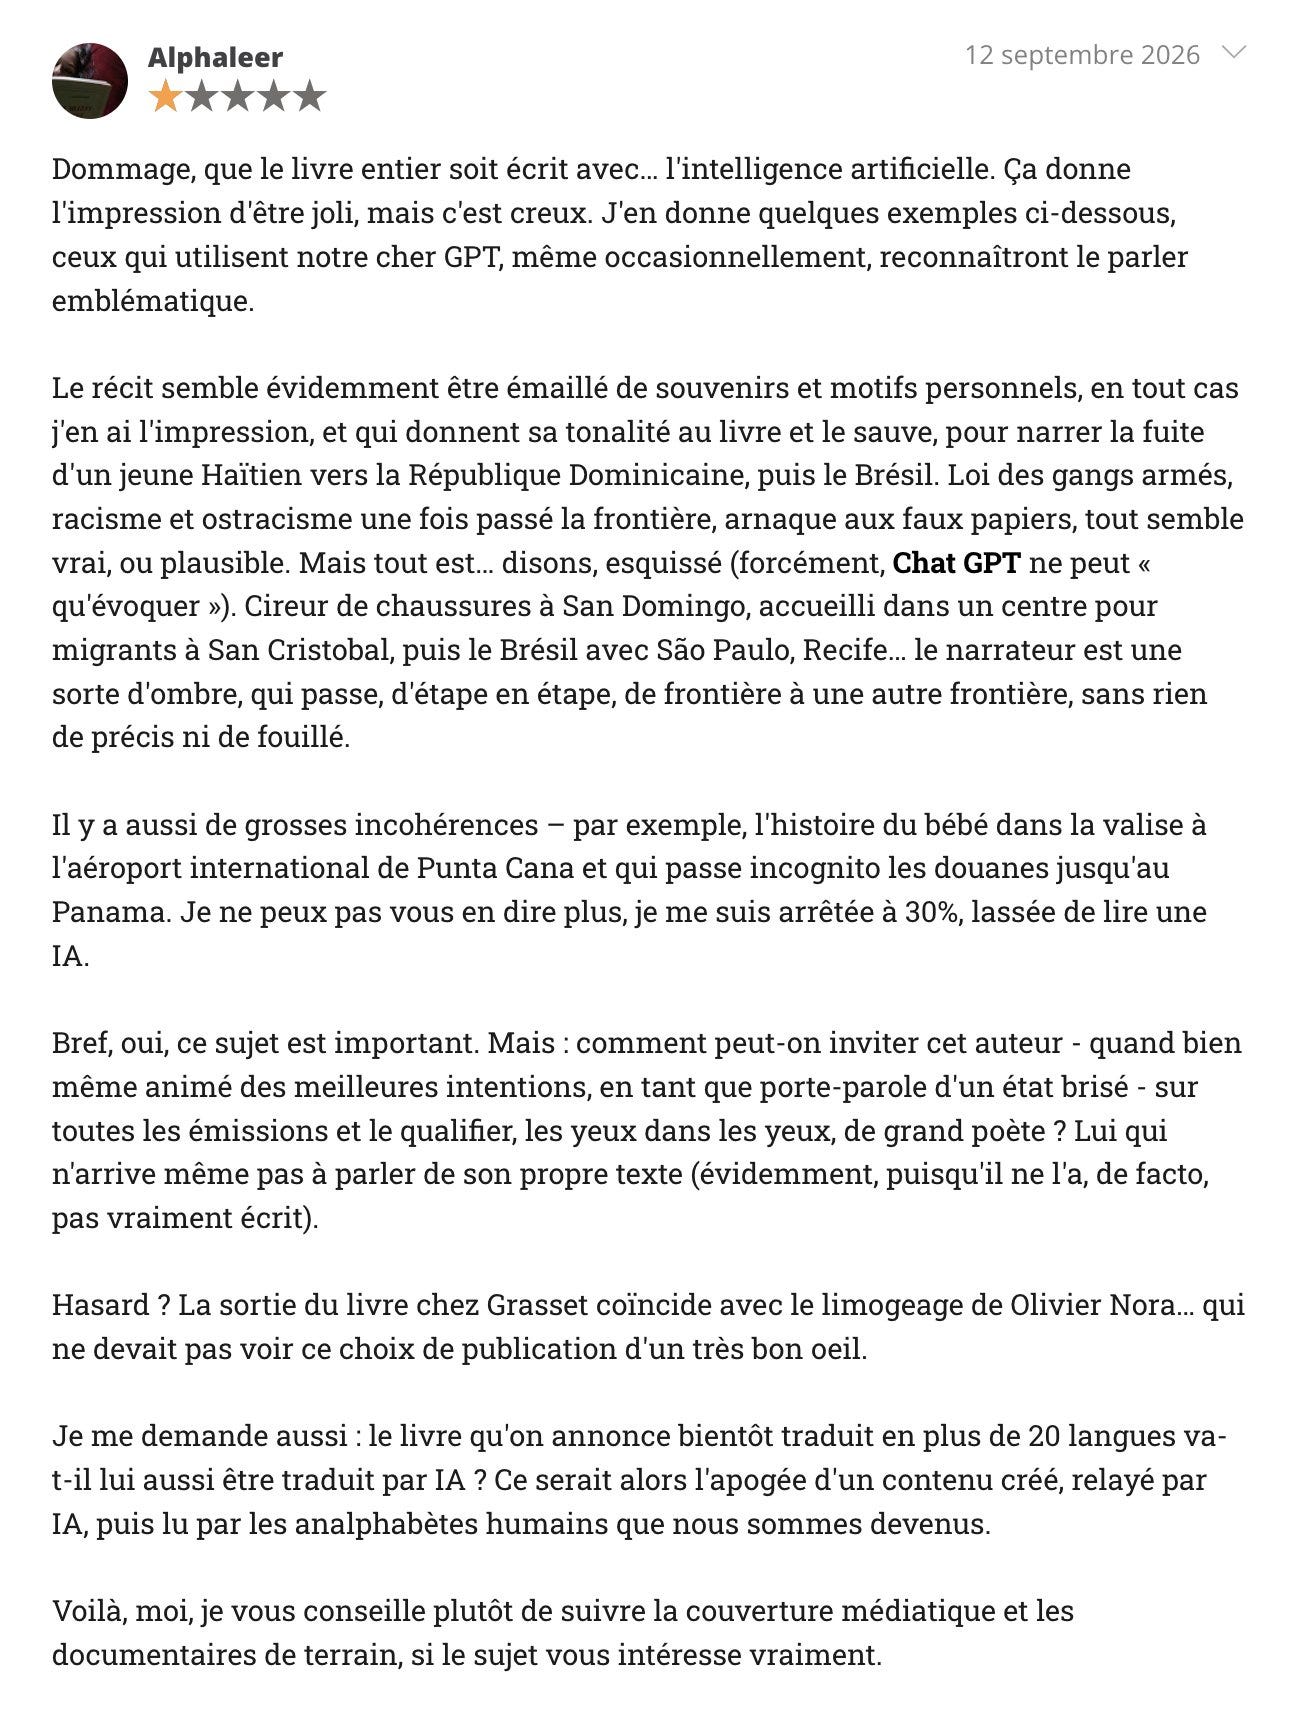
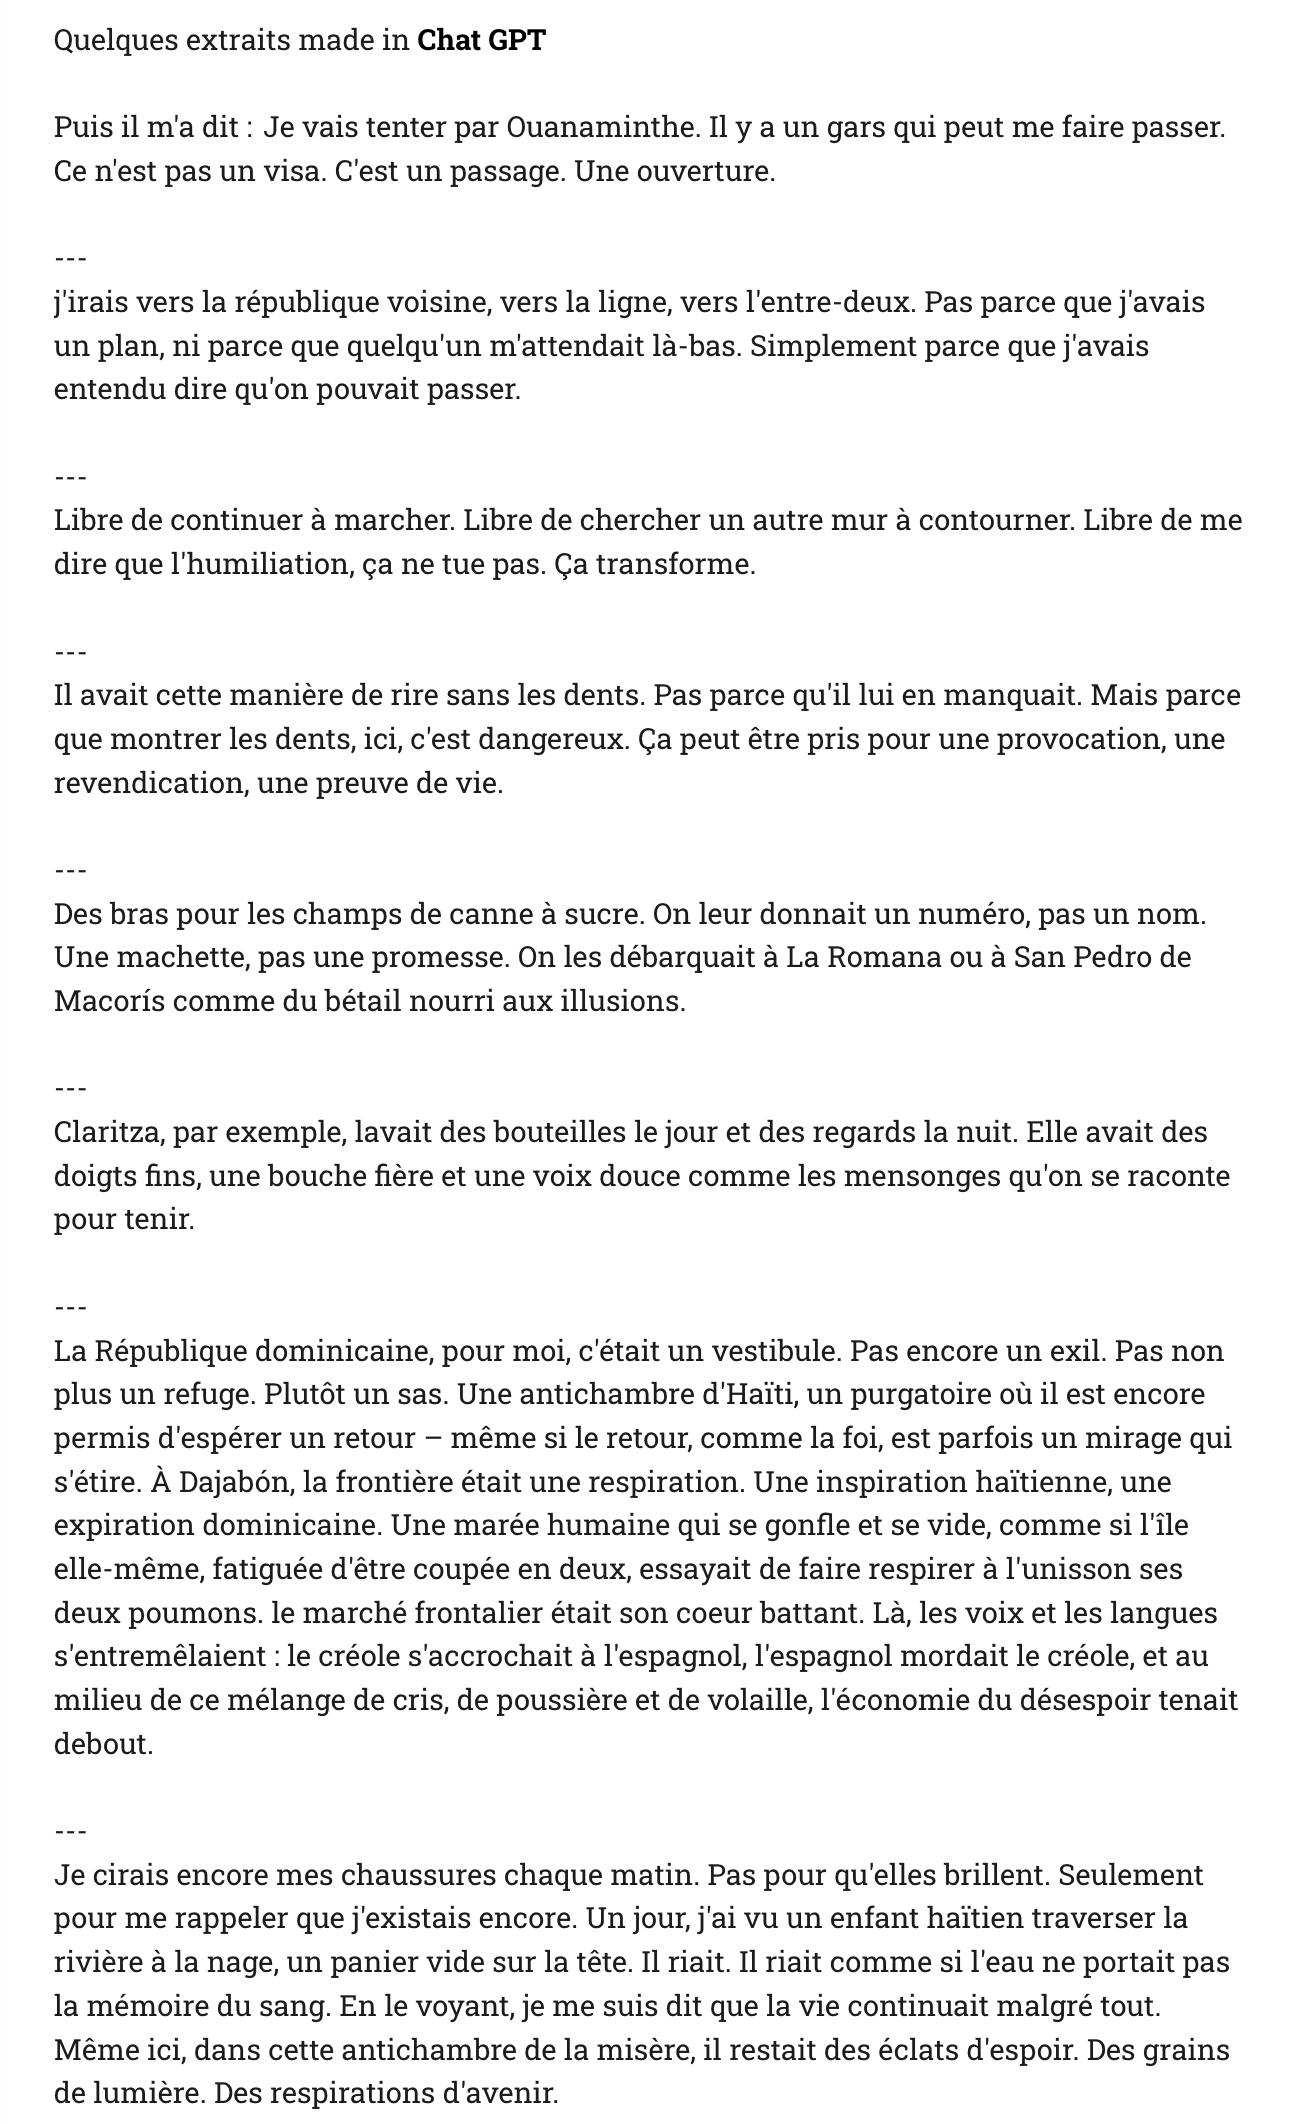
De mon côté, parmi les choses qui me font penser à de l’écriture de LLM, je relève un grand nombre de métaphores étranges, comme « un fou à l’élastique trop tendu », « le regard vide comme une assiette de riz après la guerre », « un rire jaune comme la rouille », « des enfants qui couraient entre les jambes comme des souvenirs », des « flammes [qui sautent] d’un toit à l’autre comme des enfants en colère », « un Vénézuélien maigre comme une idée morte », « la voix comme du papier mouillé », « une grand-mère hondurienne qui tremble comme une feuille mouillée », j’en passe, et des plus loufoques.
Un passage contenant des formules étranges, représentatif du livre il me semble (il s’agit des deux premiers paragraphes du chapitre 25) :
«Si le monde avait été un grand ventre, alors ceux qui n’ont jamais obtenu de rendez-vous CBP One auraient été l’indigestion, la boule récalcitrante que personne ne veut vraiment absorber. Rejetés par leur pays pour les uns, mâchés par des frontières dentelées pour les autres, transpirés jusqu’à l’os par la jungle du Darién pour les plus téméraires, recrachés avec la sécheresse d’une gorge qui refuse l’eau, puis traînés sur toute la longueur du Mexique jusqu’aux bords du Río Grande – tout ça pour finalement ne jamais voir l’écran bleu de l’application s’ouvrir pour eux comme une porte.
Tous ceux qui n’ont ni code, ni rendez-vous, ni application se fabriquent pourtant un passage. Leurs seules ressources, ce sont leur corps et leur courage. Ils traversent à mains nues, en mettant leur vie en jeu : sans protection, sans filet, sans rien d’autre que leurs bras pour porter un enfant, garder un sac hors de l’eau, s’agripper à une branche, retenir l’autre quand il glisse, et avancer quand tout autour d’eux voudrait les faire reculer. De petits groupes de six, de dix, parfois des familles entières. Des Honduriens, des Salvadoriens, des Guatémaltèques, des Vénézuéliens, des Colombiens, des Équatoriens, des Mexicains qui fuient leur propre pays comme s’ils étaient des étrangers hostiles. Ils traversent la rivière dans la nuit. Pas toujours le Río Grande en tant que tel, mais un bras secondaire, une déchirure d’eau grise, suffisamment traître pour noyer un homme distrait. L’eau est froide comme un refus. Les gens tiennent leurs sacs au-dessus de leur tête comme s’ils contenaient leur vie. Et c’est souvent vrai : ils tentent de sauver leurs téléphones, leurs derniers documents d’identité, quelques photos froissées, des boîtes de sardines qu’ils partageront comme les restes d’une dignité abîmée. »
Et puis énormément de ce n’est pas X, c’est Y, et de fins de paragraphes sentencieuses.
Voir, donc.
Une question rustique (à plusieurs égards) que je me pose : préférerais-je un « bon » livre généré pour tout ou partie par IA à une médiocrité écrite par un humain bien de chez nous ? Mais ce n’est peut-être pas le sujet.
Ce style chatgpt est percutant et fait illusion, jusqu'au moment où l'on réalise que les phrases ne procèdent pas d'une intention de dire quelque chose. On pourrait en supprimer beaucoup sans changer le sens de l'ouvrage. Les métaphores incongrues sont brillantes mais creuses, elles n'enrichissent pas le sens.
En son temps Marcel Aymé dans "le confort intellectuel" avait démonté certains totems de l'enseignement secondaire comme Les fleurs du mal ou le songe d'Athalie.